Sergio Bellucci, saggista, giornalista, specializzato nei temi dell’innovazione tecnologica
Alberto Deambrogio: Sergio Bellucci, mentre si moltiplicano le richieste di autorizzazione per la costruzione di nuovi data center sta prendendo forma una normativa che dovrebbe tentare di mettere ordine al settore: le Regioni da una parte e un DDL delega a livello parlamentare. Che pensi di questo quadro rispetto alle evidenti esigenze su diversi terreni (ambientale, sociale, ecc.)?
Sergio Bellucci: Il quadro che si sta delineando ha un merito e un limite, e il limite rischia di pesare più del merito. Il merito è che finalmente si prende atto che i data center non sono capannoni come gli altri. A febbraio la Camera ha approvato all’unanimità il disegno di legge delega che punta a un iter autorizzativo unico nazionale, alla priorità per le aree industriali dismesse, al potenziamento della rete elettrica e al contenimento dei consumi d’acqua; il testo è ora all’esame del Senato. La Lombardia, dove si concentra la parte più consistente degli impianti, ha approvato a giugno la prima legge regionale del settore, che fissa soglie di potenza oltre le quali un impianto assume rilevanza sovracomunale e incentiva il recupero del calore e l’uso di acque non potabili.
Il limite è che entrambe le norme guardano al data center come a un problema urbanistico ed energetico da semplificare, non per ciò che realmente è, cioè la fabbrica dell’epoca digitale, il luogo fisico in cui si produce e si accumula il capitale conoscitivo che oggi decide gerarchie economiche e rapporti di potere. È come regolare l’altezza dei camini senza chiedersi chi possiede la fabbrica, che cosa produce e a chi va quello che produce.
I numeri spiegano perché la questione non è tecnica. Nel 2024 i data center hanno consumato nel mondo circa 415 TWh, più dell’intero fabbisogno elettrico italiano, e uno studio dell’Università delle Nazioni Unite prevede oltre 900 TWh entro il 2030, insieme a migliaia di miliardi di litri d’acqua per il raffreddamento e a un’impronta di suolo paragonabile alla superficie di una regione come la Campania. In Italia la sola provincia di Milano, con 168 impianti, assorbe oltre il 40 per cento dei consumi nazionali del settore, e la capacità installata in Lombardia è destinata a crescere di dieci volte in cinque anni. Energia, acqua e suolo vanno valutati insieme, perché ridurre le emissioni non riduce automaticamente il consumo idrico o l’occupazione di territorio.
C’è poi un nodo che la discussione pubblica tende a rimuovere. Dichiarare queste infrastrutture di pubblica utilità significa accelerarne l’insediamento e caricare sulla collettività una parte dei costi, dalla rete elettrica alle risorse idriche, senza che la collettività riceva un ritorno proporzionato in termini di accesso, di servizi o di governo dei dati che vi transitano. È la vecchia formula della socializzazione dei costi e della privatizzazione dei benefici. Non a caso negli Stati Uniti, nella vecchia cintura industriale, crescono le proteste delle comunità locali contro rumore, consumi e aumento delle bollette, e segnali analoghi cominciano a comparire anche nell’hinterland milanese.
Né è casuale che proprio in questi giorni il Senato abbia approvato in via definitiva la legge sul ritorno al nucleare. La fame energetica dell’intelligenza artificiale è diventata l’argomento principe di una scelta che ha molto di ideologico e poco di efficiente, perché tempi e costi dell’atomo sono incompatibili con la curva della domanda, mentre rinnovabili, accumuli e carichi flessibili possono rispondere molto più rapidamente.
Che cosa servirebbe? Trasformare la semplificazione in condizionalità. Autorizzazioni rapide solo a fronte di energia rinnovabile aggiuntiva e non sottratta ad altri usi, di recupero obbligatorio del calore per il teleriscaldamento, di carichi di calcolo spostabili nelle ore di abbondanza energetica, di trasparenza pubblica sui consumi reali, di un coinvolgimento vincolante delle comunità locali e di una quota di capacità di calcolo riservata a ricerca, scuola e pubblica amministrazione. Chi usa un territorio per produrre valore deve restituirgli qualcosa di più di qualche posto di lavoro nella vigilanza.
A.D.: Le esigenze e gli interessi di chi propone i data center con l’attuale conformazione sono quelle di garantire una centralizzazione del controllo dei dati e di implementare profitti crescenti. Cosa bisognerebbe fare secondo te per recuperare terreno sia sul terreno democratico, sia su quello della distribuzione del valore che viene dal trattamento dei dati?
S.B.: Bisogna partire da una constatazione. Le tre grandi ondate del capitalismo digitale, l’informatica personale, le reti e ora l’intelligenza artificiale, non hanno prodotto soltanto ricchezza, hanno prodotto una rendita. E si tratta di una rendita diversa da quelle che conosciamo, perché non si consuma. Le rendite dell’innovazione industriale, dalla ferrovia all’elettricità, venivano erose dalla concorrenza e alla fine si trasferivano ai consumatori. Quella digitale si rafforza con l’uso, grazie a tre meccanismi che si alimentano a vicenda. L’effetto di rete, per cui una piattaforma diventa più utile quanti più utenti la usano; la dipendenza tecnica, che rende costoso cambiare fornitore anche quando esiste un’alternativa; il circuito dei dati, per cui più un sistema è usato più dati raccoglie, più migliora e più viene usato. È l’esatto contrario di un brevetto in scadenza.
I dati più recenti lo confermano. Le ricerche dello Stanford Digital Economy Lab registrano nei primi mesi del 2026 una crescita della quota di reddito che va al capitale a scapito del lavoro, senza un corrispondente aumento della produttività complessiva. Il reddito, cioè, non cresce perché il sistema diventa più efficiente, si sposta. È appropriazione di valore esistente, in larga misura generato dal lavoro implicito di miliardi di persone che, per il solo fatto di vivere e comunicare in rete, producono gratuitamente i dati su cui questi sistemi si addestrano. È ciò che chiamo plusvalore algoritmico.
Per questo le risposte settoriali, una tassa qui, una regolamentazione là, vengono riassorbite. I sistemi complessi, e l’economia digitale lo è, tornano al loro equilibrio quando le perturbazioni sono deboli e disperse. Occorre agire sul nodo che ha le connessioni più forti, e quel nodo è la proprietà del capitale conoscitivo, cioè modelli, dati e infrastrutture di calcolo.
Indicherei quattro direzioni. La prima riguarda le infrastrutture. Reti, archivi di dati e capacità di calcolo vanno considerati infrastrutture essenziali, come gli acquedotti, con accesso universale, interoperabilità obbligatoria e divieto di controllo monopolistico. Un’Europa che continua a regolare ciò che non produce, senza un proprio cloud né propri modelli di scala, dispone di una sovranità normativa priva di sovranità produttiva. Una rete pubblica e federata di calcolo, costruita con università, enti locali e comunità energetiche, sarebbe anche la risposta più concreta alla domanda sui data center. La seconda riguarda i modelli. I sistemi addestrati su dati pubblici o sul patrimonio collettivo dell’umanità devono essere resi disponibili come codice aperto, perché ciò che nasce dal sapere comune non può diventare un recinto privato. La terza riguarda il valore. Serve un dividendo sociale alimentato dalla ricchezza prodotta dai sistemi automatizzati, finanziato da una fiscalità capace di colpire la rendita là dove si forma, e il riconoscimento del lavoro implicito come contributo alla ricchezza collettiva. La quarta riguarda il lavoro organizzato. Il sindacato può già contrattare la gestione algoritmica, con trasparenza, diritto di contestare le decisioni automatiche e codeterminazione, come in parte prevede la direttiva europea sul lavoro tramite piattaforme, ma deve estendere la propria rappresentanza oltre il perimetro del lavoro contrattualizzato.
Sul terreno democratico la posta è ancora più alta. Le grandi imprese dell’intelligenza artificiale scrivono documenti che fissano valori, gerarchie normative e condizioni d’uso per miliardi di persone. Sono costituzioni di fatto, che nessuna procedura democratica ha mai discusso. Recuperare terreno significa riportare la definizione di quei valori nello spazio pubblico. La scelta tra un modello centralizzato, proprietario e chiuso e un modello decentrato, aperto e cooperativo non è tecnica. È una scelta politica, forse la più importante del nostro tempo.
A.D.: Le notizie di queste ultime settimane parlano della messa in funzione di un primo data center che utilizza neuroni umani. Quali sono secondo te le possibili ricadute, al di là delle implicazioni etiche tutte da dipanare, sull’obsolescenza dei data center che utilizzano invece chip?
S.B.: Partiamo dai fatti, perché su questa notizia si è già prodotto molto rumore. Ad agosto, a Singapore, la Facoltà di medicina dell’Università nazionale di Singapore, l’operatore DayOne e la società australiana Cortical Labs hanno presentato il prototipo di quello che è stato definito il primo data center biologico. Si tratta di un armadio con venti unità di calcolo che ospitano complessivamente circa sedici milioni di neuroni umani coltivati a partire da cellule staminali, con un consumo intorno al chilowatt. I neuroni restano vitali fino a sei mesi, poi vanno sostituiti. Le stesse fonti tecniche riconoscono che le colture attuali, bidimensionali, non sono in grado di gestire calcoli complessi o reti di grandi dimensioni, e le applicazioni indicate sono di nicchia, dalla ricerca farmacologica allo studio delle malattie neurologiche, dove conta imparare da pochi esempi più della potenza bruta.
Dunque nessuna obsolescenza a breve dei data center al silicio. Chi lo sostiene alimenta una narrazione speculativa, non un’analisi. Eppure la notizia è importante, per almeno tre ragioni.
La prima è energetica. Il cervello umano svolge funzioni che nessun sistema artificiale eguaglia consumando circa venti watt, quanto una lampadina. I grandi modelli richiedono invece campus da centinaia di megawatt. Questa distanza misura quanto sia ancora primitiva, sul piano dell’efficienza, l’architettura su cui stiamo costruendo l’intelligenza artificiale. Ogni progresso che la riduca, che venga dalla biologia, dall’informatica neuromorfica o da algoritmi più parsimoniosi, come ha mostrato il caso DeepSeek, mette in discussione le previsioni di domanda con cui oggi si giustificano centrali e data center da gigawatt.
La seconda riguarda il rischio di investimenti incagliati. L’obsolescenza vera è già dentro il silicio, perché i processori si svalutano in tre o quattro anni mentre edifici, allacci elettrici e centrali vengono pianificati per decenni. Se l’efficienza compie un salto, ci ritroveremo con infrastrutture sovradimensionate, territori impegnati e reti costruite per una domanda mai arrivata, e il conto lo pagherà la collettività. È un argomento in più per una pianificazione pubblica prudente, con clausole di reversibilità e di riconversione dei siti.
La terza è la più radicale e riguarda l’economia politica prima ancora dell’etica. Finora il capitalismo digitale ha messo al lavoro le nostre menti come produttrici inconsapevoli di dati. Con il calcolo biologico il tessuto umano diventa direttamente mezzo di produzione. Il cervello non lavora più soltanto per la macchina, diventa la macchina. Si apre così una questione di proprietà che la storia della biomedicina conosce bene, basti pensare alle cellule di Henrietta Lacks, utilizzate per decenni senza consenso né riconoscimento. Chi possiede le linee cellulari? Quali diritti hanno i donatori? A chi va il valore prodotto? Sono domande da porre adesso, prima che la tecnologia maturi e che le risposte vengano scritte, ancora una volta, nei termini di servizio di qualche impresa.
Leggi anche:
L’IA è un industria estrattiva –
L’IA è un’industria pesante –
Data center: contrastare controllo dei dati e loro valorizzazione centralizzata, aprire a soluzioni democratiche –
Data center, legge nazionale: troppo ottimismo e molti dubbi non fugati –
Sull’argomento:
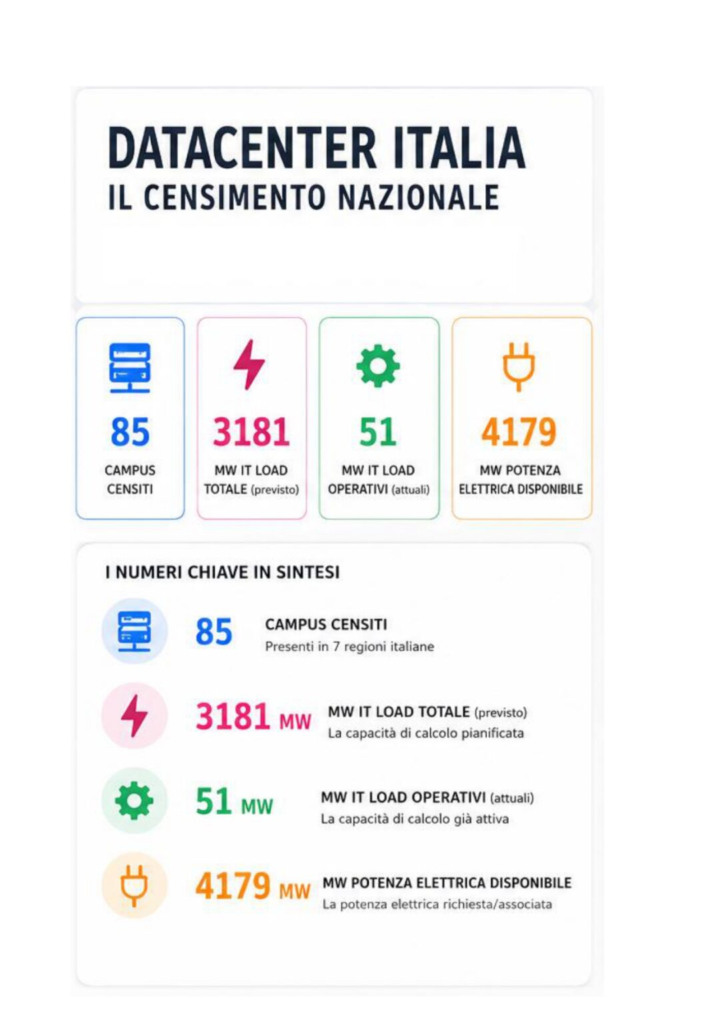
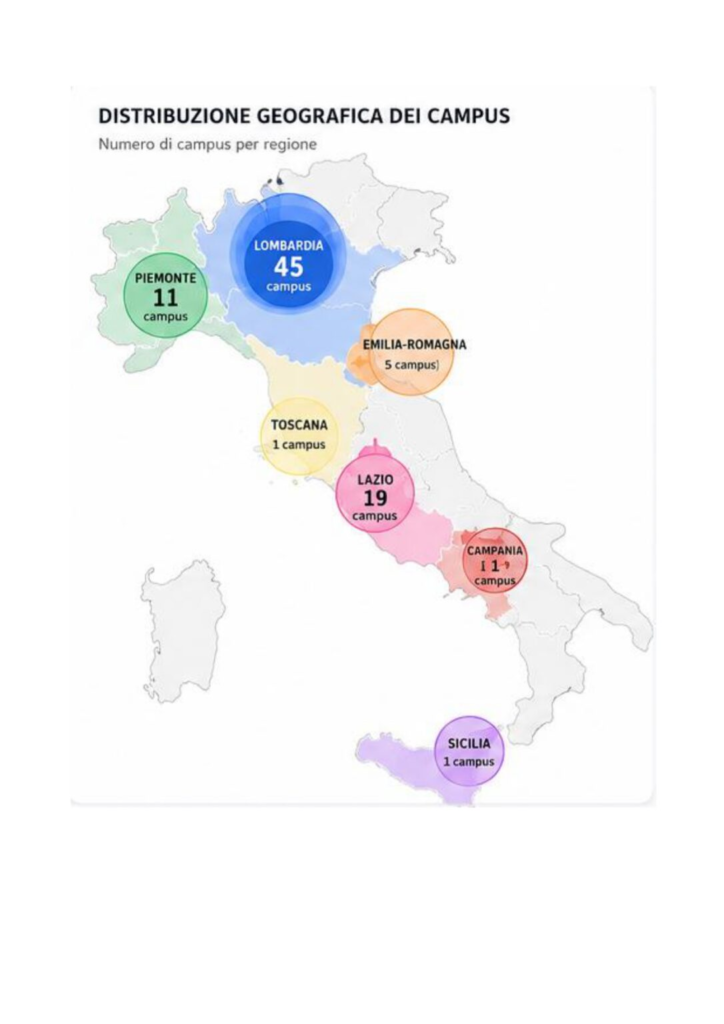
CENSIMENTO DATACENTER ITALIA e Scheda di lettura e licenza (disponibili per download)
Come si sta posizionando l’Italia in questa nuova rivoluzione industriale? Se l’IA è davvero un processo produttivo materiale, allora bisogna guardare a dove si stanno costruendo le infrastrutture che lo rendono possibile, a chi appartengono e a quali condizioni energetiche e territoriali vengono realizzate. In altre parole: quanti data center ci sono in Italia, quanti sono realmente operativi, quanti ne vogliono costruire, quanto consumano, dove sono dislocati, a chi appartengono e che cosa fanno? Di seguito il Censimento dei data center in Italia, punto di partenza di un lavoro collettivo. Sentitevi liberi di scaricarlo, modificarlo, discuterlo e condividerlo. Se avete informazioni, segnalazione di errori, stati di avanzamento, qualsiasi notizia rilevante, segnalatela, anche in forma anonima, all’indirizzo: censimentodatacenter@proton.me Allo stesso indirizzo scrivetemi per commenti o qualsiasi tipo di interlocuzione sul tema. Se siete un gruppo, un’associazione, un collettivo, un partito che si occupa di questi temi, mettiamo insieme le forze per studiare ed organizzarci su questi temi insieme. (Michela Arricale)
Censimento_DataCenter_Italia_Campus_v18Download
Scheda_di_lettura_e_licenza_ defDownload